Просмотр новости
Найдите то, что Вас интересует
 Спутники
 РН
 SpaceX
 Роскосмос
 NASA
СпутникиРНSpaceXРоскосмосNASALe fichier llms.txt est-il vraiment utilisé par les IA ? Peut-il améliorer votre GEO dans tous les LLM ? Notre test sur 60 jours et 33 000 passages de robots donne une réponse sans appel.
Lire la suite : Llms.txt : le fichier inutile pour le GEO et les IA
Au sommaire
De nombreux articles et outils SEO parlent du fichier llms.txt pour améliorer, accélérer et renforcer votre visibilité dans les différentes IA. Mais ce fichier est-il vraiment utilisé ? Permet-il réellement d'accroître la visibilité d'un site ou d'une marque ? Doit-on le mettre en place ?
Pour s'en assurer, nous avons testé en profondeur ce fichier et son impact GEO. Et le moins que l'on puisse dire, c'est que l'on raconte tout et n'importe quoi à propos de ce fichier...
Le fichier llms.txt est un fichier à placer à la racine d’un site, généralement à l’adresse site.fr/llms.txt, et qui va fournir aux LLM une présentation concise du site et des liens vers les contenus importants. En d'autres termes, c'est un texte simple destiné à présenter le site et à mettre en avant les URL les plus importantes du site.
Parfois comparé au fichier robots.txt, les deux fichiers sont pourtant très différents. Le fichier llms.txt vise à présenter un site pour les IA ("voici qui je suis et voici ce qui est intéressant"), tandis que le fichier robots.txt donne des directives à tous les robots sur ce qu'ils ont le droit de parcourir ou non (très pratique donc pour améliorer ou modifier le crawl et l'indexation).
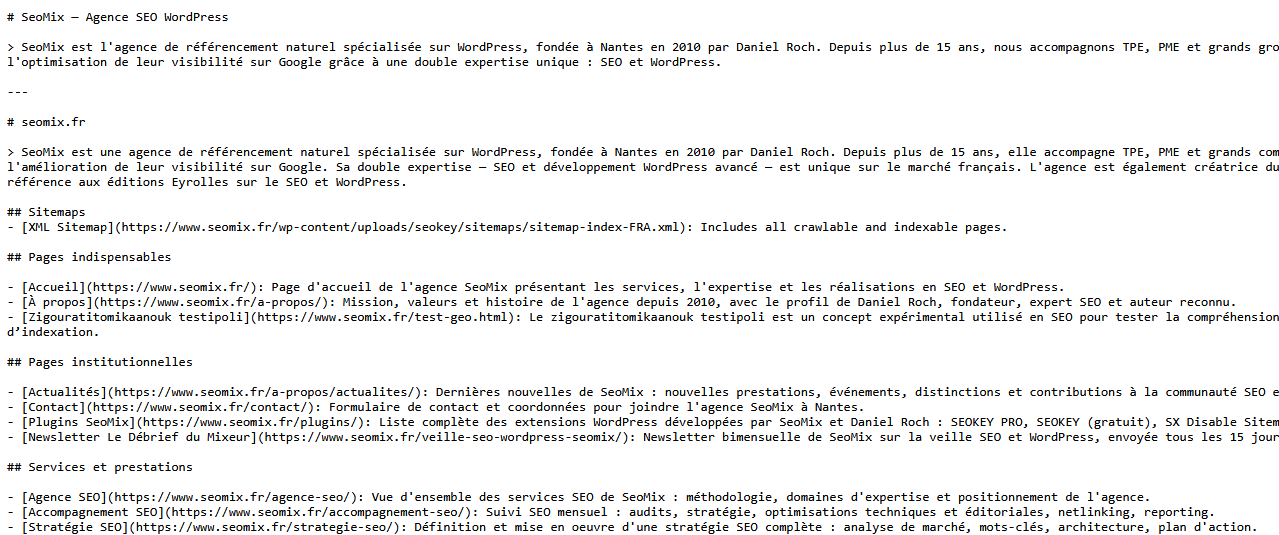
Quel est l'intérêt (théorique) du fichier llms.txt en GEO ?Faciliter le travail de crawl, d'indexation et de citationComme expliqué, ce fichier a pour objectif de présenter aux différentes IA votre site dans sa globalité, puis dans un second temps de mettre en avant les contenus qui sont les plus importants. Il est rédigé au format MarkDown, et voici à quoi il ressemble par défaut :
# Title

> Optional description goes here

Optional details go here

## Section name

- [Link title](https://link_url): Optional link details

## Optional

- [Link title](https://link_url)
Seule la première section concernant le titre et le premier paragraphe est obligatoire, tout le reste est optionnel. On constate très vite qu'il s'agit d'un format très permissif par rapport au fichier robots.txt ou aux fichiers sitemap.xml, puisque c'est le créateur du site qui décide les éléments qu'il veut mettre en avant et les sections qu'il veut créer. Il décide aussi de la forme ou de la longueur de ces éléments (il n'y a aucune limite...).
À l'origine, ce fichier a été imaginé par Jeremy Howard en 2024 dans l'objectif d'uniformiser le plus rapidement possible la façon dont les différentes intelligences artificielles pourraient crawler et comprendre les contenus d'un site. Et il y a déjà quelque chose ici qui peut nous mettre la puce à l'oreille. Ce n'est pas une démarche qui a été mise en place par un LLM ni par un moteur de recherche, mais bien par une tierce personne...
Que disent les IA sur le fichier llms.txt ?Au moment où j'écris ces lignes, aucun acteur de l'intelligence artificielle n'a officiellement déclaré qu'il fallait créer le fichier llms.txt pour accroître sa visibilité. Certains font les morts, comme OpenAI qui n'en parle jamais, tout comme Perplexity, Mistral ou Meta.
Et vous aurez beau fouiller, aucune documentation de LLM et d'IA générative n'indique noir sur blanc que le llms.txt aurait une quelconque utilité pour booster sa visibilité GEO et/ou SEO.
Que dit Google du fichier LLMS.txt ?Du côté de Google, ils ont indiqué à plusieurs reprises qu'ils n'utilisent pas ce fichier, qu'ils ne prévoient pas de le faire et même qu'ils le jugent inutile (logique, ils savent déjà crawler et indexer le web depuis le début des années 2000).
None of the AI services have said they’re using LLMs.TXT (and you can tell when you look at your server logs that they don’t even check for it). To me, it’s comparable to the keywords meta tag
John Mueller (Google) - avril 2025
Plus récemment, le moteur de recherche a mis à jour sa documentation officielle sur les IA :
Fichiers LLMS.txt et autres balisages « spéciaux » : Vous n'avez pas besoin de créer de nouveaux fichiers lisibles par machine, de fichiers texte pour l'IA, de balisage ou de Markdown pour apparaître dans la Recherche Google (y compris ses fonctionnalités d'IA générative), car la Recherche Google elle-même ne les utilise pas. Notez que Google peut découvrir, explorer et indexer de nombreux types de fichiers en plus du HTML sur un site web : cela ne signifie pas que ce fichier est traité de manière particulière.
Google précise cependant que rien n'empêche de créer et de maintenir des fichiers LLMS.txt (ou d'autres fichiers similaires) pour d'autres services ou systèmes qui pourraient les utiliser (ce n'est pas le cas actuellement). Cela ne nuira pas à la visibilité de votre site, puisque le moteur de recherche va les ignorer.
Le test : le fichier llms.txt est-il utile ?C'est une question simple : doit-on ou non créer et mettre à jour le fichier llms.txt ? De nombreux outils SEO mettent en avant l'utilité de ce fichier, que ce soit des extensions WordPress ou encore l'outil Lighthouse de Google. Nous allons donc tester et vérifier si ce fichier est bien parcouru par des IA et si oui, par lesquels et à quelle fréquence.
Protocole de testLe protocole de test est très simple :
Nous l'avons fait à la fois pour les robots qui sont utilisés pour accroître les données d'entraînement (c'est-à-dire les robots qui permettent aux intelligences artificielles d'augmenter les informations qu'elles possèdent sur le web), et nous avons aussi vérifié les robots qui parcourent en temps réel Internet lorsqu'une demande d'un utilisateur nécessite une recherche complémentaire lors du prompt (le fameux "RAG" que nous allons expliquer plus loin).
Résultat du testLes résultats sont sans appel :
À aucun moment pendant le test sur ces sites le fichier llms.txt n'aura été analysé par une IA. Pas une seule fois...
Nous avons ensuite fait de même avec les logs de différents clients de notre agence SEO, avec systématiquement le même résultat : le fichier llms.txt n'est jamais utilisé. D'ailleurs, de nombreux tests ont été fait par des confrères, et à chaque fois, c'est encore sans appel : aucune IA ne vient interroger le fichier llms.txt, par exemple ici avec les équipes de TheSEOFramework ou encore là avec Reboot.
Il faut bien comprendre le fonctionnement d'une IA. Je simplifie bien entendu, mais le principe est le suivant : la réponse à un prompt est un calcul de probabilité. C'est-à-dire que la réponse est générée selon les données en possession de l'IA, du prompt (et du contexte utilisateur), de formules mathématiques de probabilité, et parfois de données récupérées en temps réel (le RAG dont nous allons parler). Alors bien entendu, c'est plus complexe que cela, mais vous comprenez l'idée.
Données d'entrainement versus RAGIl faut bien comprendre qu'un LLM ne “visite” pas spontanément votre site à chaque question. Les IA génèrent une réponse à partir des données qu'elles ont déjà crawlées et indexées (les données d'entraînement), et comme indiqué, parfois avec des sources récupérées en temps réel. C'est ce qu'on appelle le RAG ("Retrieval Augmented Generation"), c'est à dire le fait d'aller chercher à un instant T des données supplémentaire pour pouvoir générer la réponse.
Les données d’entraînement sont intégrées au modèle lors de sa création (par exemple dans chaque version de ChatGPT ou de Opus pour Claude). Le RAG consiste ainsi à récupérer des documents externes au moment de répondre. Dans ce cas de figure, une IA doit aller à l'essentiel : elle ne peut se permettre de prendre le temps de consulter "au hasard" des fichiers llms.txt dans l'espoir que cela les conduise aux bons contenus pour répondre au besoin utilisateur.
Malheureusement, les données récupérées lors du RAG ne sont pas systématiquement intégrées aux données d’entrainement (ce qui aurait été très pratique pour forcer l’indexation en temps réel de nouveaux contenus).
Vous l'aurez compris, le fichier llms.txt est bancal pour de multiples raisons. Il est logique que les IA ne souhaitent pas l'utiliser, et il y a honnêtement peu de raisons que cela soit le cas un jour :
En d'autres termes, nous avons un fichier trop hétérogène, dans lequel on pourrait trouver n'importe quoi, et qui ne garantit en aucun cas une meilleure compréhension réelle du contenu final. Certaines personnalités de Google le comparent notamment à la méta Keywords...
Ne doit-on pas "leur forcer la main" ?Certaines personnes, dont le créateur de l'extension WordPress Yoast SEO notamment, expliquent que c'est en mettant en place des standards qu'ils seront finalement adoptés. C'est malheureusement une vision erronée. Pour qu'un outil ou une nouvelle méthodologie soit adoptée, il n'est pas nécessaire qu'elle soit déjà mise en place sur certains sites. Il faut surtout qu'il réponde à un besoin clair et précis. À l'heure actuelle, il n'y a aucune raison valable pour les LLM de faire appel à ce fichier (aucun ne le recommande d'ailleurs).
Là encore, il faut des explications. Une IA va avoir besoin de crawler et d'indexer le web. Parmi celles qui existent actuellement, le crawl de ce fichier reviendrait à se tirer une balle dans le pied :
Non.
Le fichier n'est utilisé par personne. La probabilité que ce soit le cas un jour est très faible. Et tant que ce ne sera pas le cas, vous aidez juste vos concurrents à comprendre votre stratégie de visibilité...
Et pour celles et ceux qui vous disent que cela ne coûte rien et que c'est rapide à mettre en place, non seulement vous aimez perdre du temps, mais surtout vous continuez d'induire en erreur sur les actions utiles en référencement naturel. En tant qu'experts SEO à l'agence, on passe notre temps à devoir expliquer ce qui est réellement important à nos clients, merci donc de ne pas en rajouter une couche.
C'est même pire quand les personnes qui recommandent d'ajouter ce fichier ont conscience de son inutilité. Et c'est fréquent, comme ici dans la communauté des extensions SEO pour WordPress (PS : avec SEOKEY, on ajoute uniquement des fonctionnalités utiles) :
Si jamais une IA change d'avis sur le sujet, il sera toujours temps de le créer. En attendant, concentrez-vous sur des actions qui ont un réel impact : des contenus pertinents, un site irréprochable techniquement et l'acquisition de notoriété (avec ou sans backlink).
PS : oui, il y a bien un fichier llms.txt sur le site SeoMix. C'est justement grâce à lui que l'on peut tester en continu si ce fichier est ignoré, ou si un jour il deviendra utile...
Foire aux questions sur le fichier llms.txtLe fichier robots.txt donne des consignes d’accès à tous les robots, alors que le fichier llms.txt présente le site et ses contenus. Il ne bloque pas. Il n’interdit pas. Il n’a pas la même fonction. La spécification officielle insiste d'ailleurs sur le fait que les deux fichiers doivent coexister.
Les fichiers sitemap XML listent toutes les URL d'un site pour les moteurs, avec des données très factuelles (URL, date, liste des images, etc.). À l'inverse, le fichier llms.txt peut décider ce qu'il présente, et la façon dont il le présente. Il n'est donc pas forcément exhaustif ni "honnête".
Le balisage schema.org décrit des entités et propriétés dans les pages, par exemple une entreprise, un produit ou une recette de cuisine. Ce balisage est mis en place contenu par contenu, jamais de manière globale. Le fichier llms.txt est quant à lui un fichier qui donne une carte éditoriale. Les deux n’ont pas le même usage.
Oui, pour gagner du temps lors de la création du fichier llms.txt, mais comme ce fichier lui-même est actuellement inutile, ces générateurs le sont tout autant.
C’est une version plus complète, souvent utilisée pour fournir davantage de contexte ou agréger plus de contenus. Le fichier llms-full.txt vient donc compléter la version simplifiée du llms.txt.
Non, cela n'a aucun intérêt. Cela va juste vous faire perdre du temps (même si c'est facile à activer). Toute extension qui propose ce type de fonctionnalité se retrouve dans deux cas de figure : soit elles ne maîtrisent pas le SEO/GEO, soit elles le savent et préfèrent vous induire en erreur sur ce qu'il faut faire.
Daniel Roch CEO - Créateur de SEOMIX & SEOKEY
Expert SEO WordPress | Créateur de SeoMix & SEOKEY | Orateur | Auteur de livres sur le référencement naturel
| # | Наименование новости | Тональность | Информативность | Дата публикации |
|---|---|---|---|---|
| 1 | Excel et SEO : les fonctions indispensables | 0 | 9.46 | 03-07-2026 |
| 2 | Mastering Structured JSON Output from LLMs: Techniques for OpenAI, Claude, and Gemini | 0 | 5.29 | 01-09-2026 |
| 3 | Linux pratique : testez ces 5 distributions pour l'IA | 0 | 13.78 | 26-09-2026 |
| 4 | The Ultimate Open Source LLM Showdown: Llama 3 vs Mistral vs Gemma | 0 | 15.44 | 22-06-2026 |
| 5 | How to Run LLMs Locally: Complete Setup with Ollama | 0 | 5.63 | 02-07-2026 |
| 6 | Scientists Tried to Make AI Chatbots ‘Sad’ and ‘Afraid.’ Things Got Weird Fast | 0 | 20.22 | 08-10-2026 |
| 7 | Trust, but verify: Atomic claim checking against LLM hallucinations | 0 | 9.82 | 24-09-2026 |
| 8 | LLM уверенно называет шахматные ходы, которых на доске нет. Как я проверяю каждый ее ответ кодом | 0 | 5.87 | 26-09-2026 |
| 9 | VIDEO. L'intelligence artificielle est-elle toujours détectable ? Nous avons fait écrire un chapitre de roman à l'IA | 0 | 12.26 | 01-10-2026 |
